
SAT Math 데이터 분포, 평균만 같으면 같은 집단일까요? 중심·퍼짐·이상치 읽는 법
SAT Math의 one-variable data는 평균만 계산하는 문제가 아닙니다. mean·median·range·standard deviation과 outlier를 함께 읽어 두 분포를 비교하는 법을 설명합니다.
SAT Math에서 평균을 구하는 계산은 맞았는데 데이터 문제를 틀리는 학생이 있습니다. 숫자를 모두 더해 개수로 나누는 절차는 알지만, 그 평균이 분포 전체를 얼마나 잘 설명하는지 보지 않기 때문입니다. 두 집단의 평균이 같아도 값이 모인 정도와 이상치가 다를 수 있고, 중앙값이 같아도 범위와 표준편차는 달라질 수 있습니다.
업그레이드캠퍼스는 one-variable data 문제를 대표값 하나 찾기보다 중심과 퍼짐을 함께 읽기로 설명합니다. 먼저 자료가 frequency table, histogram, dot plot, box plot 가운데 어떤 형태인지 확인하고, mean과 median으로 중심을, range와 standard deviation으로 퍼짐을 봅니다. 그다음 outlier가 어느 값에 더 큰 영향을 주는지 판단해야 분포 비교가 완성됩니다.
One-variable data는 무엇을 다루나요?
College Board의 Student Question Bank는 이 skill을 One-variable data—Distributions and measures of center and spread로 제시합니다. frequency table, histogram, dot plot, box plot에 나타난 수치 분포를 분석하고 해석하며, mean·median·range·center·spread·outlier·standard deviation을 계산하거나 비교할 수 있다고 안내합니다.
이 skill은 SAT Math의 Problem-Solving and Data Analysis 영역에 속합니다. 같은 영역에는 ratios, rates, percentages, scatterplots, probability, sample statistics와 statistical claims가 들어 있습니다. 최근에 다룬 비율·속도·단위 문제와 같은 영역이지만, one-variable data는 하나의 변수 값들이 어떻게 모이고 퍼졌는지를 읽는다는 점에서 판단 대상이 다릅니다.
Math Specifications에 따르면 SAT Math는 두 모듈에 총 44문항이며, 모듈당 35분입니다. Problem-Solving and Data Analysis는 SAT Math의 약 15%를 차지합니다. 비중만 보고 문제 수를 고정해 예상하기보다, 공식 Question Bank에서 skill을 좁혀 여러 표현을 익히는 편이 안전합니다.
평균이 같아도 분포는 다를 수 있습니다
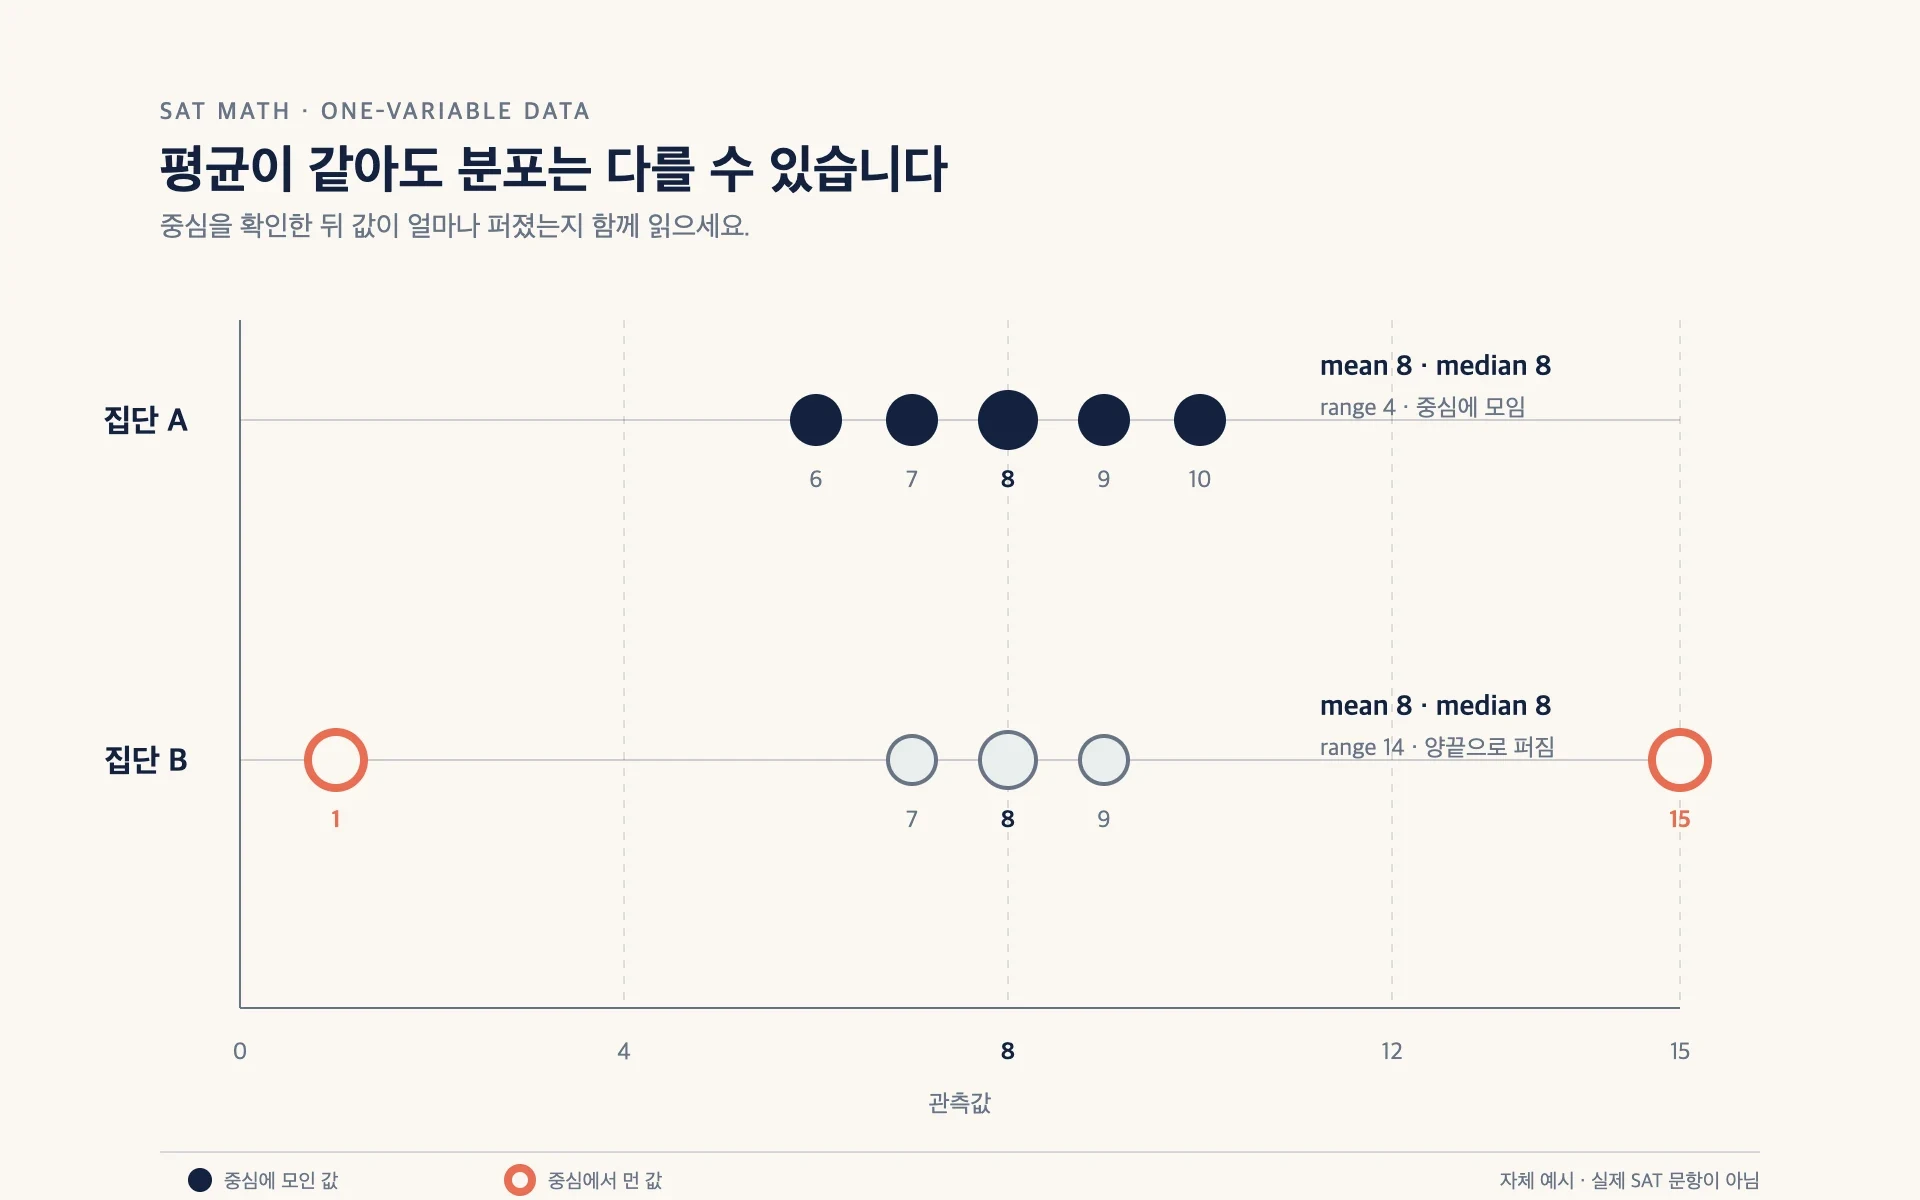
다음 두 자료를 생각해 보겠습니다. A는 6, 7, 8, 9, 10이고 B는 1, 7, 8, 9, 15입니다. 두 집단 모두 mean과 median이 8입니다. 중심만 보면 같지만 값이 퍼진 정도는 크게 다릅니다.
| 확인 항목 | 집단 A | 집단 B | 읽을 수 있는 차이 |
|---|---|---|---|
| mean | 8 | 8 | 평균은 같음 |
| median | 8 | 8 | 가운데 위치도 같음 |
| range | 4 | 14 | B가 더 넓게 퍼짐 |
| 극단 값 | 6, 10 | 1, 15 | B의 양끝 값이 중심에서 멂 |
이 자체 예시는 평균이 같으면 분포도 같다는 판단이 왜 위험한지 보여 줍니다. 실제 SAT 문항에서는 dot plot이나 표가 주어질 수 있고, standard deviation을 직접 계산하지 않아도 어느 분포가 더 큰지 비교하게 할 수 있습니다. 중심에서 멀리 떨어진 값이 많을수록 퍼짐이 큰지 살펴보세요.
Mean과 median은 중심을 다르게 잡습니다
Mean은 모든 값을 더해 개수로 나눈 값입니다. 데이터의 각 값이 바뀌면 합계가 달라지므로, 매우 크거나 작은 값의 영향을 받습니다. Median은 값을 순서대로 놓았을 때 가운데에 오는 값입니다. 데이터 개수가 짝수라면 가운데 두 값의 평균을 사용합니다.
예를 들어 4, 5, 5, 6, 30의 mean은 10이고 median은 5입니다. 30이 합계를 크게 올려 mean이 대부분의 값보다 멀어졌습니다. Median은 순서의 가운데를 사용하므로 같은 outlier의 영향을 덜 받습니다. 이 자료에서 일반적인 값을 설명하려면 median이 중심의 위치를 더 잘 보여 줄 수 있습니다.
그렇다고 median이 언제나 더 좋은 값이라는 뜻은 아닙니다. 자료가 대칭에 가깝고 큰 outlier가 없다면 mean은 모든 관측값을 반영하는 유용한 중심입니다. 두 대표값 가운데 하나를 습관적으로 고르면 분포를 놓칩니다. 분포의 모양과 극단 값을 본 뒤 어떤 값이 질문에 맞는지 판단해야 합니다.
선택지가 outlier를 추가하면 mean과 median이 모두 같은 만큼 변한다고 말한다면 실제 위치를 확인하세요. Outlier는 mean을 크게 움직일 수 있지만, median은 가운데 순서가 바뀌지 않으면 그대로이거나 조금만 달라질 수 있습니다.
Range와 standard deviation은 퍼짐을 봅니다
Range는 최댓값에서 최솟값을 뺀 값입니다. 계산이 간단하고 전체 폭을 빠르게 보여 줍니다. 다만 양끝 두 값만 사용하므로, 가운데 값들이 어떻게 모였는지는 설명하지 못합니다.
Standard deviation은 값들이 mean에서 얼마나 떨어져 있는지를 반영하는 퍼짐의 척도입니다. SAT에서 항상 복잡한 공식을 직접 계산하는 것은 아닙니다. 두 dot plot이 같은 mean을 가질 때 어느 쪽 값들이 mean 주변에 더 모였는지 보고 standard deviation의 크기를 비교할 수 있습니다.
값들이 중심 가까이에 빽빽하게 모이면 standard deviation은 작아지는 방향입니다. 중심에서 멀리 떨어진 값이 많거나 양쪽으로 넓게 퍼지면 커지는 방향입니다. 가로 폭이 넓다만 보지 말고, 각 위치에 값이 몇 개 있는지도 확인하세요. 같은 range를 가진 두 분포도 한쪽은 중심에 많이 모이고 다른 쪽은 전체 구간에 고르게 퍼질 수 있습니다.
질문에 따라 Range와 standard deviation의 역할이 달라집니다. 전체 최소·최대 폭을 묻는다면 range가 직접적인 값이고, 값들이 mean 주변에서 얼마나 퍼졌는지 묻는다면 standard deviation이 맞는 척도입니다.
Outlier가 들어오면 무엇이 움직이나요?
Outlier는 나머지 값들과 멀리 떨어진 관측값입니다. 무조건 오류라는 뜻은 아닙니다. 실제로 드문 관측일 수도 있고, 입력 실수일 수도 있으며, 다른 조건에서 나온 값일 수도 있습니다. SAT 문제에서는 outlier가 mean, median, range와 분포 해석에 어떤 영향을 주는지 묻습니다.
큰 outlier 하나를 추가하면 합계와 최댓값이 바뀝니다. Mean은 그 값의 영향을 받아 커질 수 있고, range도 최댓값이 멀어지면 커집니다. Median은 정렬된 값의 가운데 위치를 사용하므로 변하지 않거나 mean보다 작게 움직일 수 있습니다.
효과를 외우기보다 실제 자료의 위치를 확인하세요. 데이터 개수가 적으면 한 값을 추가하면서 가운데 위치가 바뀌어 median도 달라질 수 있습니다. outlier는 median에 영향을 주지 않는다처럼 항상 성립하는 문장으로 외우면 예외를 놓칩니다. 일반적으로 mean이 더 민감하다는 방향을 이해하되, 문항의 값으로 최종 확인해야 합니다.
Outlier를 제거하는 문제도 같습니다. 제거 전후의 합계, 개수, 최솟값·최댓값, 가운데 위치를 차례로 확인하세요. 무엇이 바뀌는지 계산하기 전에 어떤 척도가 어떤 값에 의존하는지 표시하면 실수를 줄일 수 있습니다.
Dot plot과 histogram은 높이만 보면 안 됩니다
Dot plot은 각 값 위에 점을 쌓아 빈도를 보여 줍니다. 점 하나가 관측 하나를 뜻하는 경우가 많아 데이터 개수와 실제 값의 위치를 직접 셀 수 있습니다. Mean이나 median을 구할 때 같은 값이 몇 번 반복되는지 빠뜨리지 않아야 합니다.
Histogram은 값을 구간으로 묶어 막대 높이로 빈도를 나타냅니다. 개별 관측값을 정확히 알 수 없는 경우가 있으므로, 구간 안의 모든 값이 막대 가운데 값과 같다고 가정해서는 안 됩니다. 문제에서 평균을 정확히 계산할 수 있는 자료인지, 분포의 모양과 빈도만 비교해야 하는지 구분하세요.
두 그래프 모두 세 방향으로 읽습니다.
- 값이 어디에 모였는가: center의 대략적인 위치를 봅니다.
- 얼마나 넓게 퍼졌는가: 전체 폭과 중심에서 떨어진 정도를 봅니다.
- 빈도와 극단 값이 어떤가: 높은 막대 하나와 멀리 떨어진 값의 역할을 구분합니다.
막대가 가장 높은 구간은 mode에 가까운 정보를 줄 수 있지만, 곧바로 mean이나 median과 같다고 단정할 수 없습니다. 분포가 비대칭이거나 outlier가 있으면 중심의 여러 척도는 서로 다른 위치에 놓일 수 있습니다.
Box plot은 다섯 위치와 구간 폭을 읽습니다
Box plot은 minimum, first quartile, median, third quartile, maximum을 바탕으로 분포를 요약합니다. 상자의 왼쪽과 오른쪽 경계, 상자 안의 median 선, 양쪽 whisker가 각각 어떤 값을 나타내는지 먼저 확인하세요.
상자의 폭은 중간 50% 데이터가 놓인 구간을 보여 줍니다. 두 box plot의 상자 폭이 다르면 가운데 절반의 퍼짐이 다릅니다. Median 선의 위치를 비교하면 중심을 볼 수 있고, 전체 whisker 범위는 자료의 폭을 보여 줍니다. 축 눈금 간격이 같은지도 반드시 확인해야 합니다.
Box plot만으로 mean이나 개별 값의 정확한 빈도를 알 수는 없습니다. 상자 모양이 같다고 모든 데이터 값이 같은 것도 아닙니다. 그래프가 제공하는 요약과 제공하지 않는 정보를 구분하는 것이 중요합니다.
두 분포를 비교할 때는 B의 median이 더 크다, A의 중간 50%가 더 좁게 모였다처럼 척도와 방향을 함께 말하세요. A가 더 좋다 또는 B가 더 안정적이다는 평가는 질문의 실제 맥락과 기준이 있어야 합니다.
두 분포는 중심·퍼짐·모양 순서로 비교합니다
여러 분포가 한 화면에 나오면 한 가지 숫자만 비교하지 마세요. 다음 순서를 사용하면 누락을 줄일 수 있습니다.
| 단계 | 확인할 것 | 말하는 방식 |
|---|---|---|
| 중심 | mean 또는 median의 위치 | 어느 집단의 대표 위치가 더 큰가 |
| 퍼짐 | range, standard deviation, 상자 폭 | 어느 집단의 값이 더 넓게 흩어졌는가 |
| 모양·극단 | 대칭, 치우침, 빈 구간, outlier | 대표값을 왜 조심해서 읽어야 하는가 |
예를 들어 두 반의 시험 점수 median이 같아도 한 반은 점수가 가운데에 모이고 다른 반은 낮은 점수와 높은 점수로 넓게 퍼질 수 있습니다. 전형적인 위치는 비슷하지만 B의 변동이 더 크다처럼 중심과 퍼짐을 함께 말해야 비교가 정확합니다.
문제에서 same mean and different standard deviations를 제시하면 mean을 다시 계산하는 데 시간을 모두 쓰지 마세요. 평균이 같다는 조건을 받아들이고, 어느 분포의 값들이 그 평균에서 더 멀리 떨어져 있는지 봅니다. Dot plot의 점 위치와 빈도가 판단 근거입니다.
그래프에 실제 생활 맥락이 붙어 있어도 수학 관계를 먼저 확인합니다. 배송 시간, 수면 시간, 점수처럼 단위가 다르면 해석 문장은 달라지지만, 중심과 퍼짐을 비교하는 구조는 같습니다.
가상 예시로 척도 선택을 연습합니다
다음은 풀이 원리를 설명하기 위한 자체 예시입니다. 실제 SAT 문항이 아닙니다.
한 동아리가 두 주 동안 과제 완료 시간을 기록했습니다. 첫째 주 값은 28, 29, 30, 31, 32분이고 둘째 주 값은 10, 29, 30, 31, 50분입니다. 두 주의 mean과 median은 모두 30분입니다.
첫째 주 range는 4분이고 둘째 주 range는 40분입니다. 둘째 주 값들은 중심에서 더 멀리 떨어져 있으므로 standard deviation도 더 큰 방향입니다. 평균 완료 시간은 같지만 둘째 주의 변동이 더 크다가 자료에 맞는 비교입니다.
여기서 둘째 주 학생들이 평균적으로 더 느렸다고 말하면 mean이 같다는 조건과 맞지 않습니다. 두 주의 수행이 같다고 말하면 퍼짐의 차이를 놓칩니다. 첫째 주에는 모든 학생이 비슷한 시간에 끝냈다는 표현은 값들이 가깝다는 점을 설명하지만, 관측 대상이 학생인지 같은 학생의 여러 과제인지 문항 맥락을 확인해야 합니다.
숫자만 계산한 뒤 끝내지 말고 한 문장으로 해석하세요. 척도 이름, 비교 방향, 실제 단위를 함께 쓰면 선택지의 과장이나 대상 변경을 찾기 쉽습니다.
Student Question Bank에서 한 skill만 좁혀 연습합니다
College Board의 Student Question Bank는 Math 문항을 domain, skill과 difficulty로 좁힐 수 있습니다. Problem-Solving and Data Analysis와 One-variable data—Distributions and measures of center and spread를 선택해 같은 판단을 반복해 보세요.
처음에는 그래프 종류를 한 번에 섞지 않아도 됩니다. Dot plot에서 실제 값을 세고 mean·median·range를 구하는 연습을 한 뒤, 두 분포의 standard deviation 방향을 비교합니다. 다음에는 histogram에서 구간과 빈도를 읽고, box plot에서 median과 중간 50%의 퍼짐을 비교합니다.
오답 노트에는 계산식보다 놓친 판단을 적습니다. 점 하나를 빠뜨림, histogram 구간을 개별 값으로 간주함, 같은 mean만 보고 spread를 보지 않음, outlier가 median도 크게 바꾼다고 단정함처럼 기록하세요. 같은 오류가 반복되면 다음 세트의 목표가 분명해집니다.
시간을 잴 때는 네 질문만 남겨 봅니다. 자료 형태는 무엇인지, 중심은 어디인지, 퍼짐은 어느 쪽이 큰지, outlier가 어떤 척도를 움직이는지 확인합니다. 계산기는 산술을 도울 수 있지만 어떤 척도를 비교할지는 학생이 결정해야 합니다.
학부모는 답보다 비교 문장을 확인하세요
부모가 복기를 도울 때 평균이 얼마야?만 묻지 마세요. 학생이 계산을 마친 뒤 다음 질문을 이어 보세요.
- 같은 mean을 가진 두 분포가 실제로 같은 모양인가?
- Median과 mean이 크게 다르면 어떤 값이 영향을 주었는가?
- Range와 standard deviation은 각각 퍼짐의 어느 부분을 말하는가?
- Outlier를 추가하거나 빼면 어떤 척도가 왜 달라지는가?
학생의 답에 척도 이름과 비교 방향이 함께 들어 있는지 들어 보세요. B가 더 퍼졌다고 말하면 어떤 근거가 있는지, 평균이 대표값이다라고 말하면 outlier와 분포 모양을 확인했는지 묻습니다. 정답을 대신 계산하지 않아도 판단 순서를 점검할 수 있습니다.
One-variable data는 평균 공식 하나를 시험하는 영역이 아닙니다. 같은 중심을 가진 분포도 퍼짐과 극단 값이 다를 수 있다는 사실을 읽고, 질문에 맞는 척도를 선택하는 능력이 필요합니다. Center, spread, shape와 outlier를 한 묶음으로 보면 그래프가 달라져도 비교 기준을 유지할 수 있습니다.
공식 출처
- College Board, Student Question Bank: Math Questions — https://satsuite.collegeboard.org/practice/student-question-bank/math
- College Board, Math Specifications — https://satsuite.collegeboard.org/k12-educators/about/alignment/math
- College Board, Problem-Solving and Data Analysis — https://satsuite.collegeboard.org/sat/whats-on-the-test/math/types/problem-solving
관련 프로그램
1:1 튜터링 알아보기